Perspectiva técnica
Gestión de rutas multi-sucursal con Machine Learning y programación dinámica
Una arquitectura abierta y reproducible para que una distribuidora con varios centros deje de planificar rutas como islas: predicción de demanda, clustering por capacidad real y un plan diario coordinado.
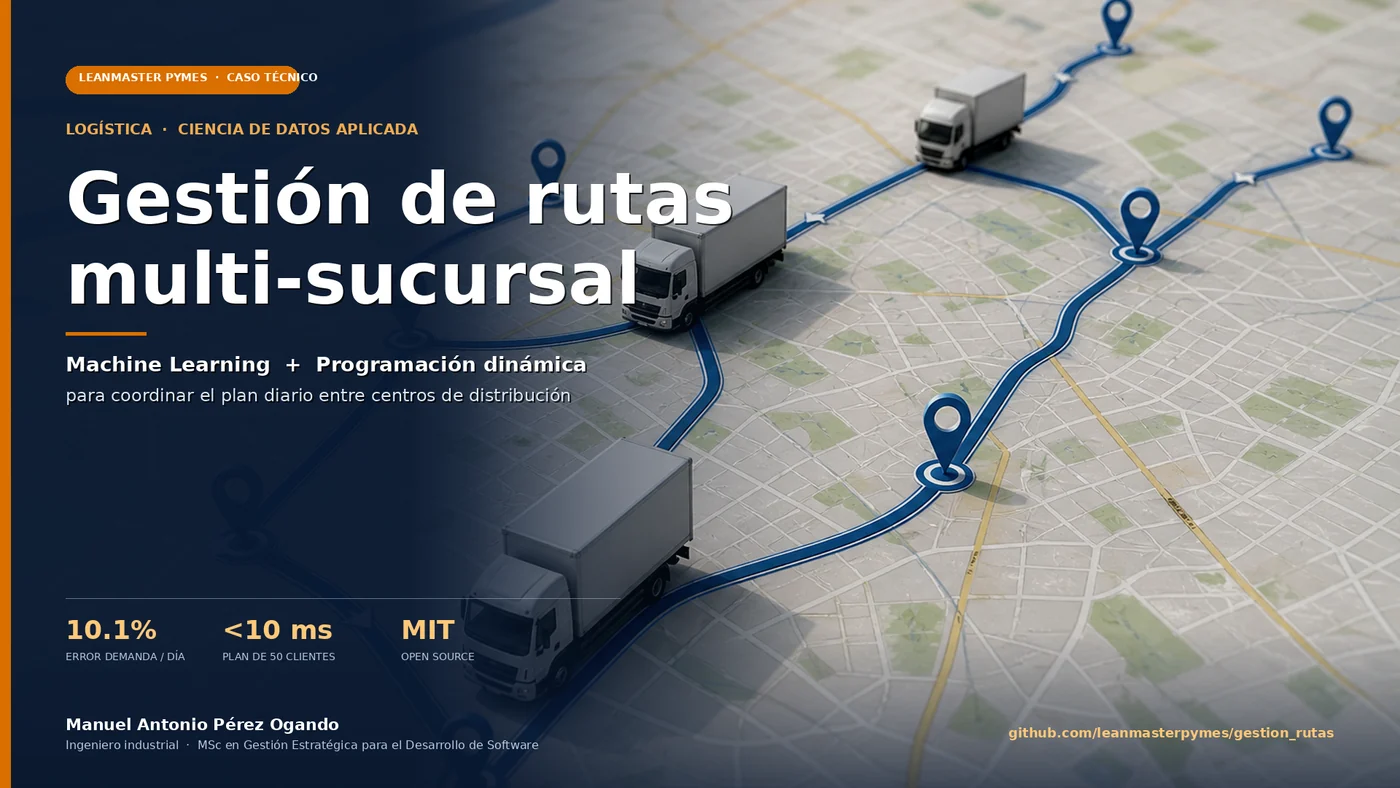
Una arquitectura abierta, reproducible y de bajo costo para que cualquier distribuidora con varios centros de distribución deje de planificar rutas como islas y empiece a operar un plan diario coordinado.
Demo y código sin instalación
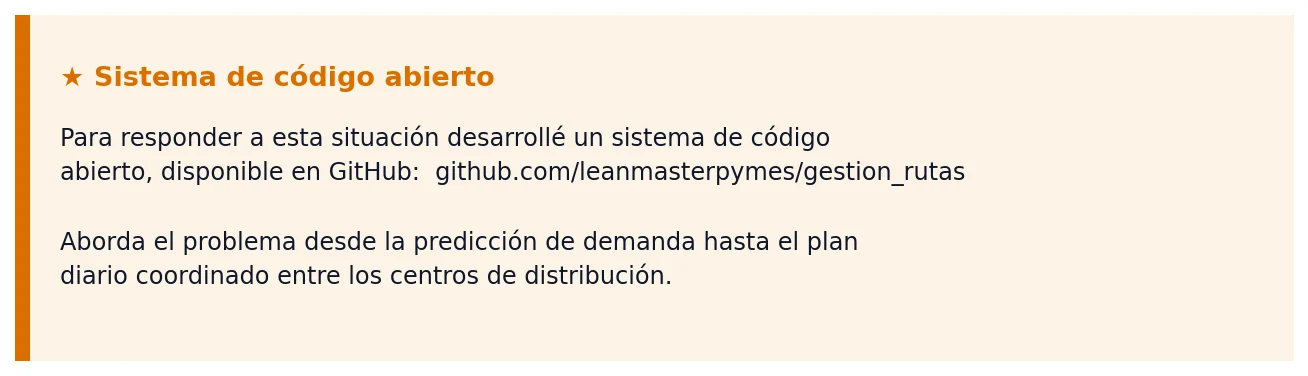
Antes de leer, abre el sistema funcionando en tu navegador:
- ⭐ Repositorio en GitHub (código abierto, MIT): clónalo y ejecuta el sistema completo en tu computadora.
- 📓 Notebook en Google Colab: el flujo completo paso a paso, sin instalar nada.
- 👉 Planificador interactivo en Streamlit: plan diario con mapa, métricas y descarga del plan en CSV, sin instalación.
1. El problema operativo que se repite en la mayoría de las distribuidoras
En la mayoría de las distribuidoras con varios centros de distribución que he visitado (sucursales, depósitos regionales o incluso fábricas), dos camiones de la misma empresa terminan a tres cuadras del mismo cliente el mismo día. Cada centro planifica su ruta como una isla: arma su propia plantilla, reparte sus pedidos, y nadie se entera de que el centro vecino está pasando por la misma calle dos horas después. El resultado se paga en silencio: kilómetros duplicados, combustible perdido, horas extra del chofer y el clásico camión flash subcontratado a última hora cuando la demanda real superó la capacidad asignada.
El patrón suele ser el mismo:
- Cada centro estima su demanda al ojo sobre el promedio de las últimas semanas, sin un modelo que capture estacionalidad ni tendencia.
- La asignación cliente–centro se hereda desde hace años y nadie la cuestiona, aun cuando dos centros hayan crecido en zonas que ya se solapan.
- Cuando el plan del día queda corto, se subcontrata un camión flash con un costo 30 a 50% superior al de un camión propio. Nadie mide cuánto se va al año por este renglón.
- Cuando el plan queda holgado, los choferes regresan a la rampa con espacio vacío y se justifican horas que no se trabajaron en ruta. La utilización real de la flota nunca aparece en el reporte mensual.
2. La arquitectura propuesta
La solución se compone de cuatro capas, todas basadas en software libre y reproducibles desde el repositorio. El sistema toma dos insumos principales: el histórico de pedidos de los clientes y la disponibilidad de cada centro de distribución (cantidad de camiones y capacidad de cada uno). Conocer la disponibilidad antes de asignar es lo que permite respetar la capacidad real de despacho de cada centro y evitar la sobrecarga.
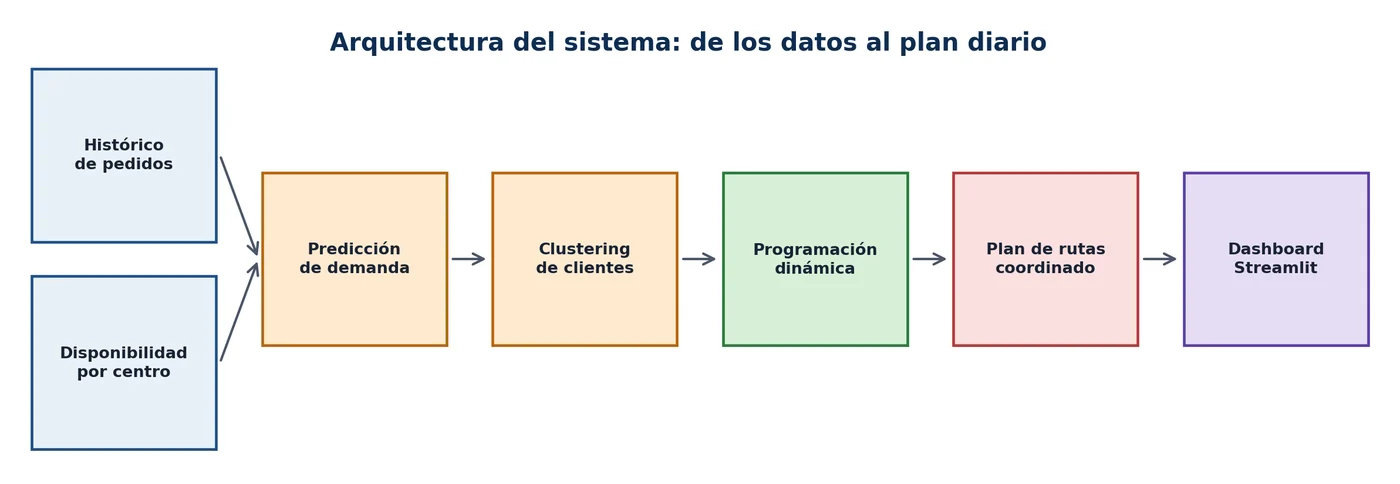
De los datos al plan diario, pipeline end-to-end de la solución.
- Predicción de demanda por cliente: un modelo aprende los patrones de pedido de cada cliente y proyecta cuánto pedirá mañana, capturando estacionalidad semanal, tendencia mensual y comportamiento individual.
- Clustering inteligente de clientes: los clientes se agrupan en zonas de ruteo balanceadas por la capacidad real del camión, no por divisiones administrativas heredadas.
- Optimización de la ruta: cada zona se resuelve con un algoritmo clásico de optimización que minimiza kilometraje y respeta ventanas horarias.
- Coordinación entre centros: antes de salir, el sistema reasigna clientes fronterizos para que dos centros no se pisen el territorio.
El resultado es un plan diario donde cada cliente tiene un centro de distribución, una ruta y una posición en la secuencia, con cifras reproducibles a partir de un caso de estudio que cualquiera puede correr en su computadora.
3. Predecir antes de planificar
El insumo principal del ruteo es la demanda esperada de cada cliente para el día siguiente. Sin esa predicción, todo el resto del sistema opera con promedios planos que no capturan la realidad: lunes y martes pico, domingo valle, clientes que crecen, clientes que cambian de hábitos.
El modelo aprende de cuatro tipos de señales:
- El calendario (día de la semana, mes, semana del año), que captura los ciclos predecibles del negocio.
- El historial reciente del cliente (cuánto pidió hace 1, 7 y 14 días), que captura la inercia de pedidos y los hábitos individuales.
- La tendencia (medias móviles de 7 y 30 días), que suaviza ruido y muestra si el cliente está creciendo, estable o decreciendo.
- El perfil del cliente (tipo de comercio, ventana horaria, nivel de demanda base).
Validación rigurosa
La validación se hace de forma rigurosa: los últimos 30 días del histórico se reservan como prueba, sin que el modelo los vea durante el aprendizaje. Esto evita la fuga de información típica de los splits aleatorios sobre series de tiempo, donde un modelo puede “ver el futuro” durante el entrenamiento y reportar métricas optimistas que después no se reproducen en producción.
Sobre el caso de estudio del repositorio (50 clientes, 540 días de histórico), el modelo logra estas métricas en datos que el modelo no usó para aprender:
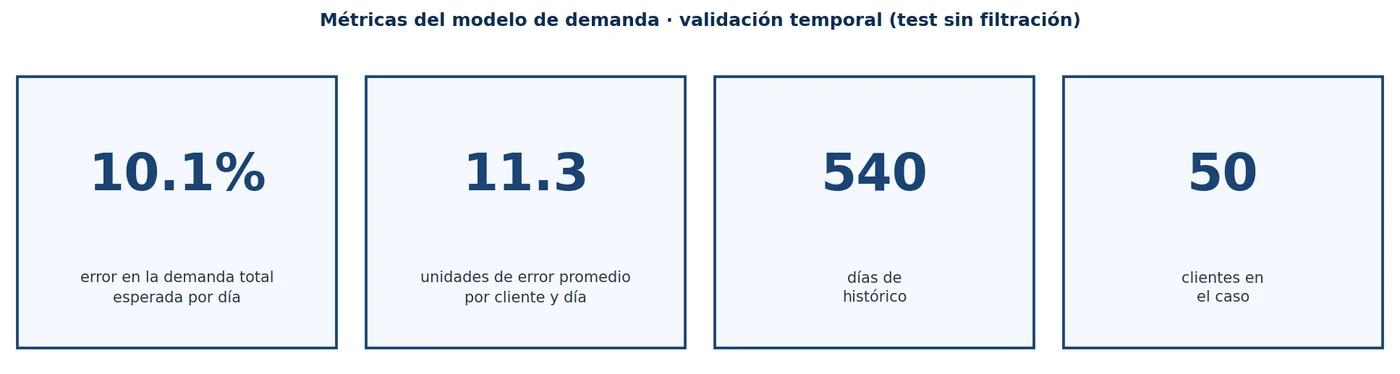
La métrica que más importa para la planificación de capacidad es el error sobre la demanda agregada por día: si la flota total va a recibir alrededor de 870 unidades en pedidos para mañana, el modelo se equivoca en promedio un 10% (cerca de 87 unidades arriba o abajo). Ese rango de error es suficiente para dimensionar correctamente cuántos camiones cargar y permite anticipar días pico antes de que aparezca la sobrecarga.
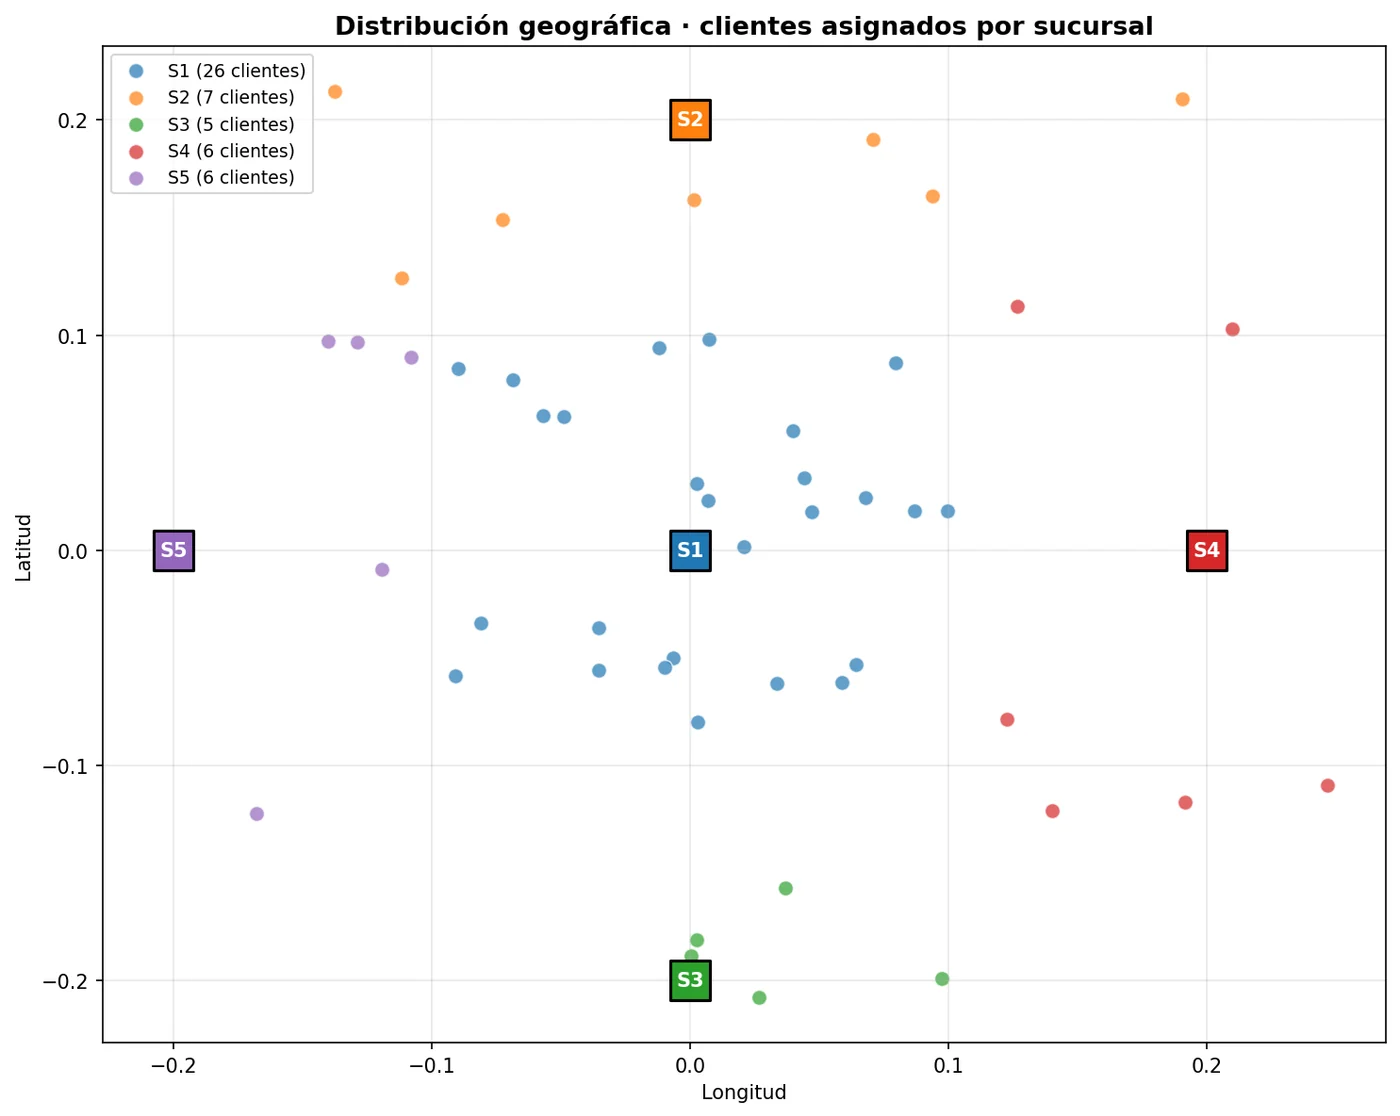
Distribución geográfica de los clientes con su centro asignado por el sistema.
4. Cómo se optimiza la ruta
La optimización de rutas se apoya en una idea de los años sesenta que sigue siendo el corazón de los mejores sistemas industriales: descomponer un problema grande en piezas pequeñas, resolver cada pieza una sola vez y reutilizar el resultado. La técnica se llama programación dinámica, y el algoritmo clásico que la materializa para el ruteo es Held-Karp (1962).
El método tiene un límite práctico: cuando una ruta crece de 15 clientes en adelante, el cálculo se vuelve demasiado pesado. La estrategia del sistema es respetar ese límite y usar descomposición por zonas: el clustering reduce 50 clientes a varias rutas pequeñas, cada una con menos de 15 clientes, donde el algoritmo exacto resuelve el óptimo en milisegundos. Cuando una zona excede los 15 clientes, se sustituye automáticamente por una variante aproximada que sigue siendo óptima en la práctica.
El resultado, en cifras del propio sistema, es contundente: un plan completo de 50 clientes y 5 centros de distribución se calcula en menos de 10 milisegundos.
5. Coordinación entre centros, el verdadero cambio de paradigma
El gran cambio que introduce esta arquitectura no es el algoritmo de optimización en sí, sino el paso previo de asignar clientes a centros de distribución con visión global. La asignación tradicional, que es la que opera hoy en la mayoría de las distribuidoras, asigna cada cliente al centro más cercano y termina ahí. Funciona razonablemente bien cuando la red es pequeña, pero cuando crece, dos centros empiezan a invadirse el territorio.
La asignación coordinada plantea el problema desde otro lugar: cada centro tiene una capacidad real (cantidad de camiones multiplicada por la capacidad de cada camión), y cada cliente debe asignarse de modo que se minimice la distancia total respetando esa capacidad. El sistema resuelve este planteo en milisegundos y elimina los solapamientos sin necesidad de redibujar zonas a mano.
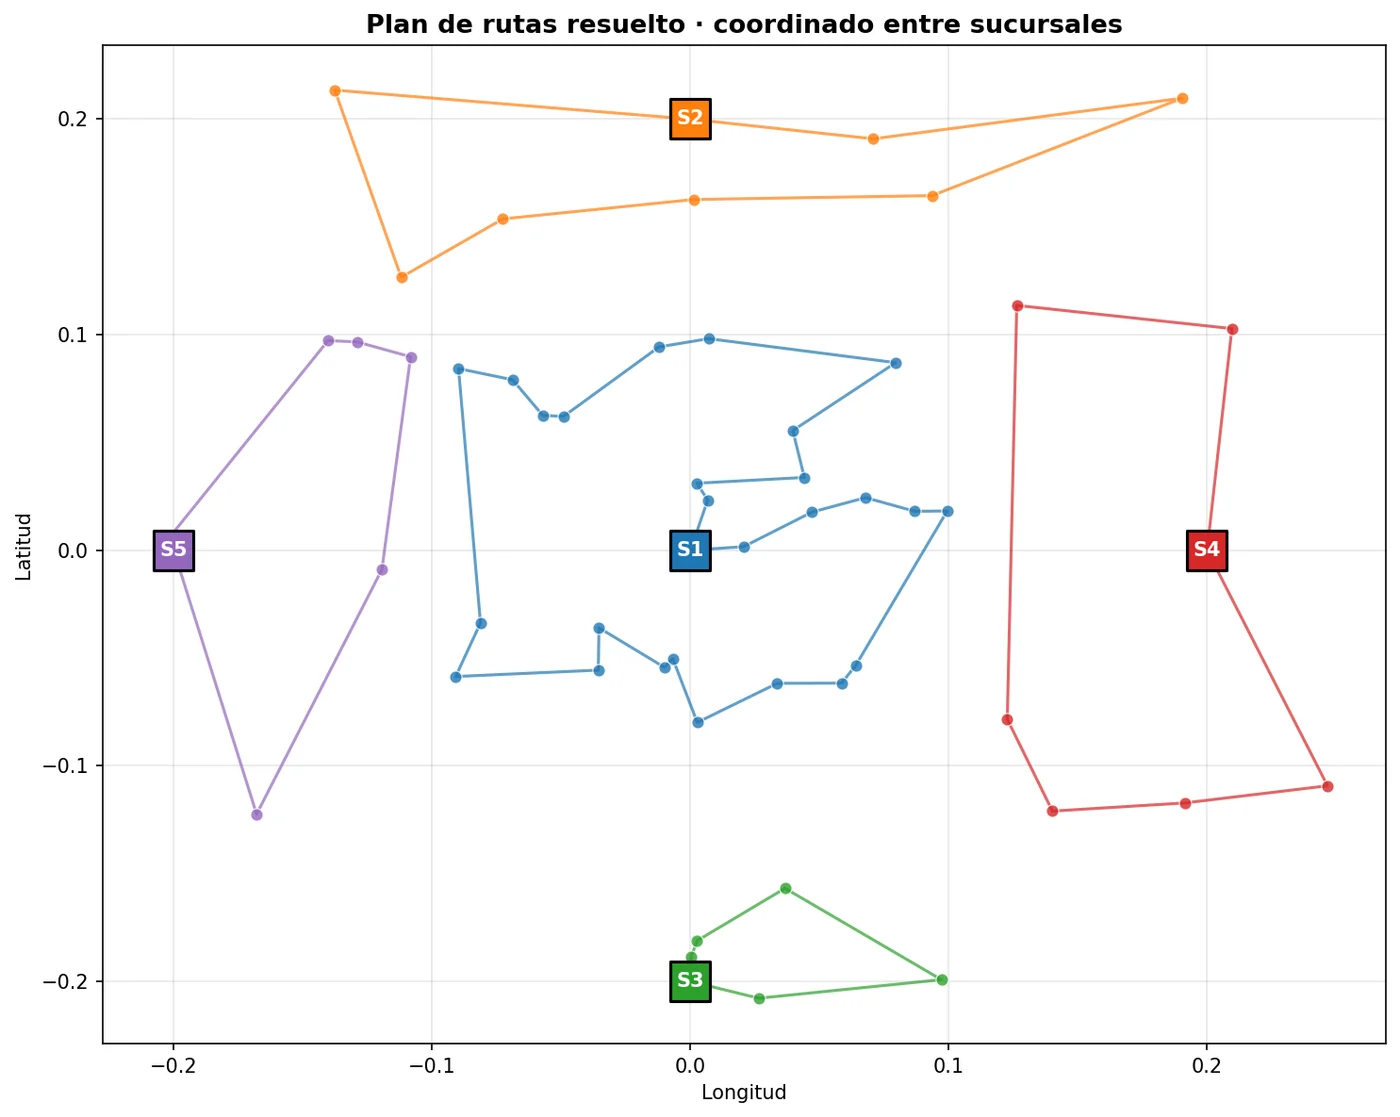
Plan de rutas resuelto, cada color representa un centro de distribución con sus rutas coordinadas.
6. Validación contra el estándar industrial
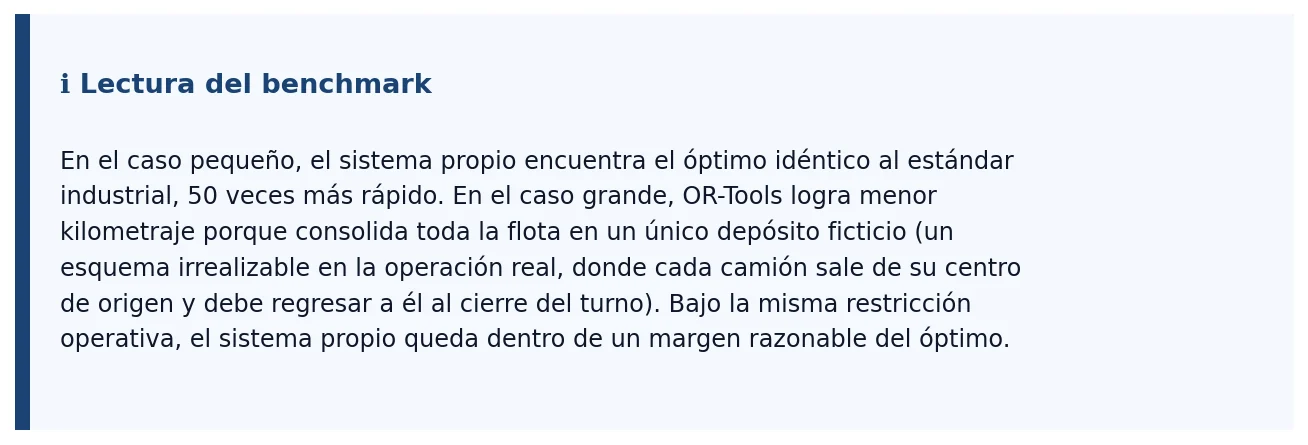
Para validar la calidad del sistema, el motor propio se compara lado a lado con Google OR-Tools, el estándar industrial de problemas de ruteo. Sobre el mismo caso de estudio:
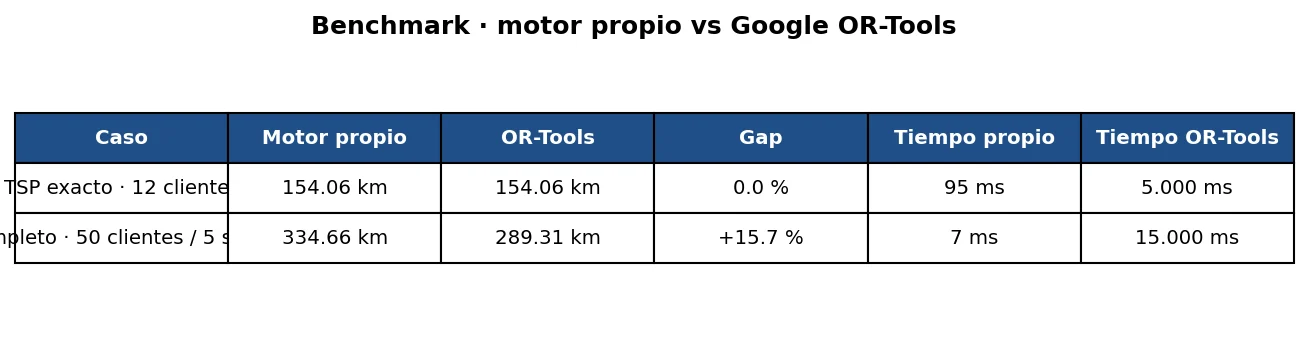
Benchmark lado a lado · motor propio vs Google OR-Tools sobre el mismo dataset.
7. Cinco beneficios operativos medibles
Las cifras siguientes corresponden a referencias públicas del sector (Gartner, McKinsey, Project44, FarEye, ORTEC, OptimoRoute) cuando una arquitectura de planificación con predicción de demanda y ruteo automatizado se implementa con disciplina. No son promesas: son rangos documentados de mejora, con su traducción directa al impacto en el negocio.
15 a 30% menos kilometraje total
Menos combustible, menos desgaste de flota, menos peajes y menos tiempo improductivo en ruta. Si una distribuidora corre 50.000 km al mes, esto se traduce en un ahorro de 7.500 a 15.000 km mensuales.
15 a 25% más clientes por ruta
Mayor productividad por chofer y por camión. Si hoy un camión visita 20 clientes al día, puede llegar a 23 o 25 con el mismo recurso. Cuando la red crece, no es necesario contratar más camiones de inmediato.
20 a 25% menos costo de combustible
Ahorro directo en el renglón más visible del estado de resultados de logística. Si el combustible representa entre 25 y 30% del costo logístico total, esto se traduce en una reducción de 5 a 7% en el costo logístico total.
10 a 20% menos horas extra del chofer
Menos pago de horas extra, menor rotación de personal y menor riesgo laboral. El chofer fatigado tiene entre 2 y 3 veces más probabilidad de accidente; estabilizar la jornada protege a la operación y al negocio.
30 a 60% menos subcontrataciones flash
El ahorro más subestimado de toda la arquitectura. Un camión flash subcontratado cuesta entre 30 y 50% más que un camión propio. Si hoy 10% de las rutas se cubren con flash y se baja a 4 o 5%, ese es ahorro puro al cierre del mes, mes tras mes.
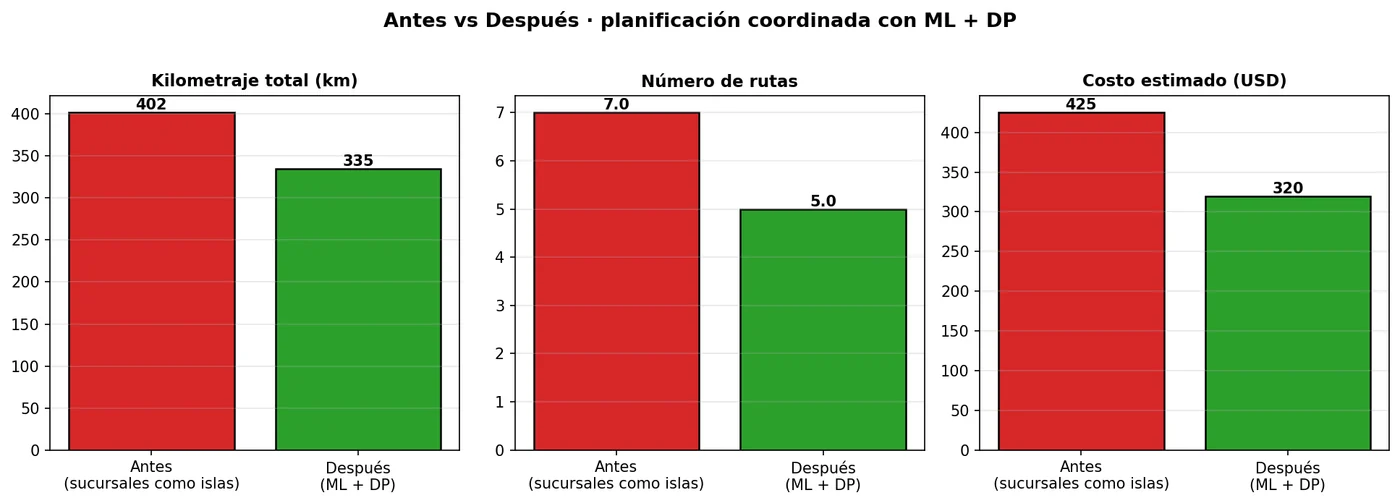
Comparativa antes y después, planificación coordinada con predicción y optimización.
8. Cómo probar el sistema
Opción rápida, sin instalar nada
Hace clic en el badge “Open in Colab” del repositorio. Las celdas ejecutan en orden el flujo completo: caso de estudio, predicción, clustering, optimización, validación contra el estándar industrial y mapa del plan resuelto. En menos de dos minutos, la solución está corriendo en una pestaña del navegador.
Opción para implementarlo, clonar el repositorio
🔗 El código completo está publicado bajo licencia MIT en github.com/leanmasterpymes/gestion_rutas. Cualquiera puede clonarlo, correr el sistema en su computadora y conectar sus propios datos de clientes. El planificador abre en el navegador y permite cargar un archivo de clientes propio para generar un plan personalizado.
🔬 ¿Querés profundizar en el detalle técnico?
Para profesionales técnicos, estudiantes de Investigación de Operaciones y desarrolladores que quieran entender el sistema por dentro, el repositorio incluye una versión extendida del artículo y un notebook ejecutable paso a paso con:
- La formulación matemática del subproblema y la ecuación de Bellman aplicada al ruteo.
- La tabla de complejidad teórica y el momento exacto en que cada enfoque deja de ser viable.
- El código fuente completo de los siete módulos del motor.
- El benchmark detallado contra Google OR-Tools, con tiempos de cómputo y gap de optimalidad.
- Lecturas recomendadas (Held & Karp 1962, Bellman 1962, Toth & Vigo 2014).
👉 Abrir el repositorio en GitHub para acceder al material extendido.
Si este contenido le resultó útil
👀 Abra el notebook en Colab antes de cerrar la pestaña, corre con un solo clic, sin instalación.
⭐ Marque el repositorio en GitHub para darle visibilidad y poder clonarlo en su empresa.
💬 Comparta el artículo con su responsable de logística o de operaciones; el sistema puede evaluarse en una sola jornada con los datos de su propia distribuidora.
📩 Si desea adaptar la solución a su flota o integrarla a sus sistemas, puede contactarme mediante mensajes directos.