Perspectiva técnica
La pelea entre Excel y el código (Python) ya es falsa
Les di los mismos datos de ventas de Walmart a una hoja de cálculo y a varios modelos de Machine Learning, con las mismas reglas. El mejor bajó el error un 18 %, pero el dato que cambia las cosas es otro.
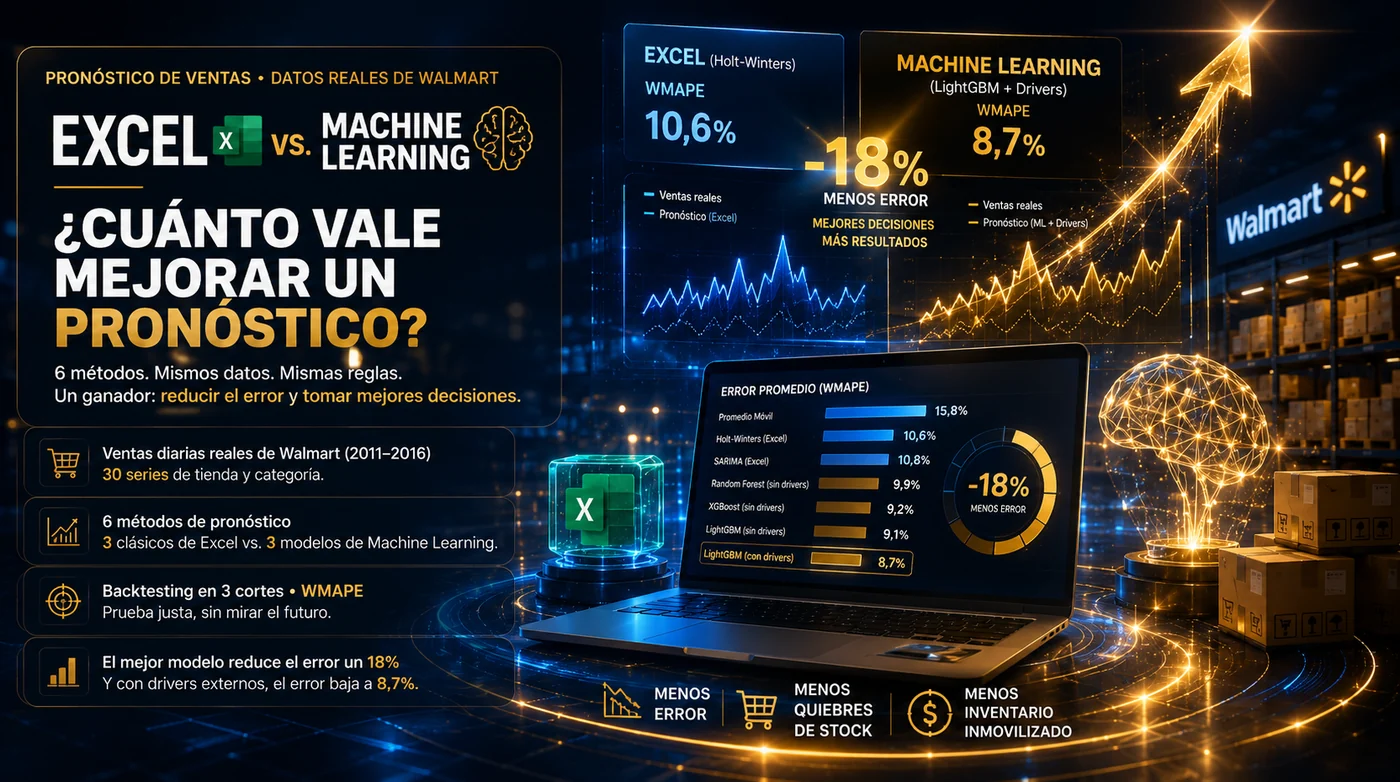
Le di los mismos datos de ventas de Walmart a una hoja de cálculo y a varios modelos de Machine Learning, con las mismas reglas. El mejor modelo redujo el error de pronóstico un 18% sobre el mejor método de Excel. Pero el dato que de verdad cambia las cosas no es ese.
Lectura · 8 min · Análisis + experimento · Pronóstico de ventas
1. El experimento, en una frase
Quería responder una pregunta concreta, sin opiniones de por medio: para pronosticar ventas, ¿cuánto mejor es un modelo moderno que una buena fórmula de hoja de cálculo? Así que monté una prueba con las mismas reglas para los dos lados.
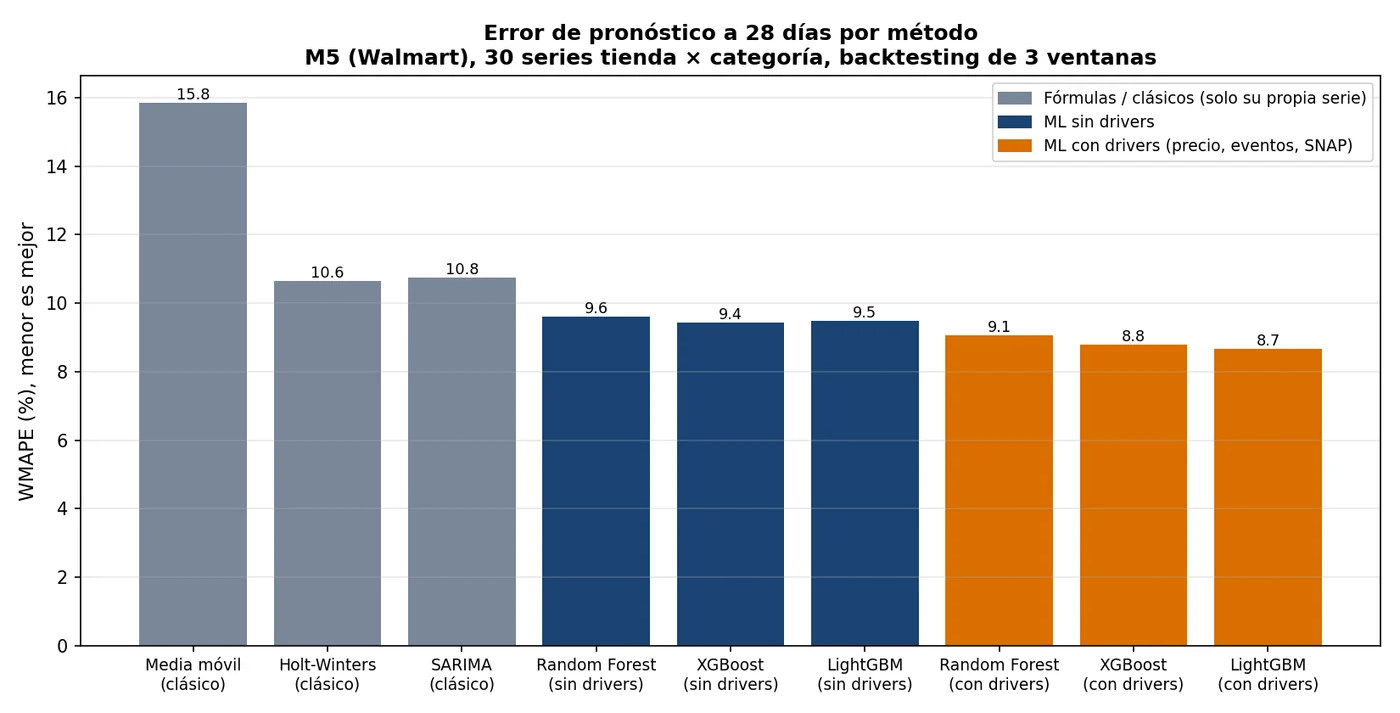
Usé el dataset público de la M5 Forecasting Competition, ventas diarias reales de tiendas de Walmart entre 2011 y 2016. Lo organicé en 30 combinaciones de tienda y categoría de producto (por ejemplo, las ventas diarias de alimentos en una tienda de California, o las de artículos del hogar en otra de Texas). Cada una de esas combinaciones es lo que técnicamente se llama una serie: el historial de ventas, día a día, de un tipo de producto en un punto de venta. Es exactamente lo que una empresa necesita pronosticar para decidir cuánto comprar o producir. Sobre esas 30 series puse a competir a seis métodos: tres clásicos (el promedio móvil de toda la vida, Holt-Winters y SARIMA) y tres de Machine Learning (Random Forest, XGBoost y LightGBM). A los tres modelos de Machine Learning, además, los probé en dos variantes: solo con su propio historial de ventas, y sumándoles datos externos del negocio como el precio y las promociones (los drivers, que veo más adelante). De ahí que la gráfica de resultados muestre nueve columnas y no seis. Los números completos los verás en esa gráfica más abajo.
Para que la comparación fuera justa usé una técnica llamada backtesting, que en español sería algo así como “prueba sobre el pasado”. La idea es sencilla: en vez de pedirle a un método que adivine un futuro que todavía no conocemos, lo hago viajar al pasado. Me paro en un punto de la historia de ventas (por ejemplo, hace dos años), le pido que pronostique los 28 días siguientes y comparo ese pronóstico contra lo que de verdad pasó, porque ese resultado ya lo tenemos registrado. Así cada método se mide contra la realidad y no contra una opinión. Repetí el ejercicio en tres cortes distintos del pasado, deslizando esa ventana de prueba, para que ningún método ganara por suerte en una sola fecha. El error más caro en este tipo de pruebas es la fuga temporal, dejar que el modelo vea sin querer información del futuro; lo evité construyendo cada variable solo con datos anteriores al día que se pronostica.
Medí el error con WMAPE, que es el error promedio expresado como porcentaje de las ventas (mientras más bajo, mejor el pronóstico). Con eso sobre la mesa, subamos la escalera peldaño por peldaño.
2. Primer peldaño: el promedio móvil
Es lo que hace la mayoría: promediar las ventas de las últimas semanas y proyectar ese número hacia adelante. Es rápido, lo entiende cualquiera y no necesita nada más que una celda.
También es, de lejos, lo peor que probé. El promedio móvil dejó un WMAPE de 15,8%. No porque esté roto, sino porque ignora todo lo que hace interesante a una serie de ventas: que sube los fines de semana, que tiene una temporada alta cada año, que se mueve cuando hay una promoción. Aplana la realidad a un solo número y proyecta ese número plano.
3. Segundo peldaño: el Excel que casi nadie usa bien
Aquí quiero ser honesto, porque es donde se cae la caricatura. Una hoja de cálculo no es un juguete. Excel trae desde hace años una función llamada PRONOSTICO.ETS, que por dentro es un método estadístico serio: el suavizamiento exponencial de Holt-Winters, capaz de aprender la tendencia y la estacionalidad de una serie sin que el usuario programe nada.
Cuando lo usé bien, el salto fue grande. Holt-Winters bajó el error de 15,8% a 10,6%, y un modelo estadístico clásico como SARIMA quedó prácticamente igual (10,8%). Es decir, gran parte de la distancia entre “pronóstico amateur” y “pronóstico decente” se cruza sin salir de la hoja de cálculo, simplemente usando la función correcta en lugar de un promedio a mano.
Y conviene detenerse en esto, porque es parte del fondo del asunto: el problema rara vez es la herramienta. El problema es que muchísima gente que pronostica ventas todos los días nunca pasó del primer peldaño, no por falta de capacidad, sino porque nadie le mostró que el segundo estaba ahí, a una fórmula de distancia.
4. Tercer peldaño: los modelos, y una sorpresa
Subí entonces a los modelos de Machine Learning. La familia que mejor funciona en este tipo de datos es la de los árboles potenciados (lo que se conoce como gradient boosting: XGBoost y LightGBM), modelos que combinan miles de reglas simples para capturar patrones que una fórmula lineal no ve.
Esperaba que empataran a Holt-Winters mientras no les diera información extra. Me equivoqué, y la sorpresa es interesante. Incluso sin datos adicionales, solo con la historia de cada serie, los modelos ya superaron a Holt-Winters, bajando el error a alrededor de 9,4%.
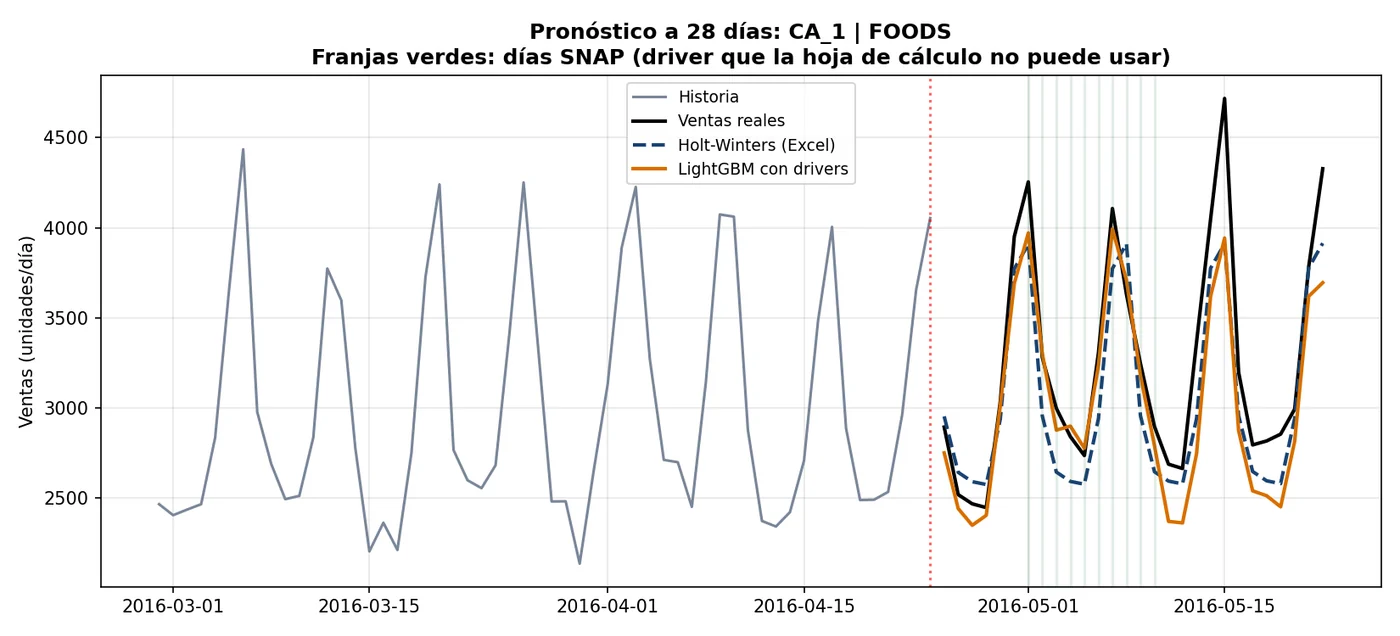
¿Por qué? Porque Holt-Winters, tal como lo trae la hoja de cálculo, aprende bien la estacionalidad semanal, pero le cuesta la anual. Los modelos, en cambio, miran sin esfuerzo las ventas del mismo día del año anterior y la posición dentro del calendario. Capturan varias estacionalidades a la vez. Esa es una ventaja estructural, no un truco de ajuste.
Hasta aquí la conclusión es ordenada: a más sofisticación de método, menos error. Pero el salto más revelador no fue cambiar de algoritmo. Fue darle a los modelos algo que la hoja de cálculo, por diseño, no puede usar.
5. El salto real: lo que la hoja de cálculo no puede ver
Una fórmula de pronóstico, por buena que sea, solo mira el pasado de la propia serie de ventas. No sabe por qué se vendió más un día. Los drivers, las variables externas que de verdad mueven la demanda, quedan fuera de su alcance.
A los modelos sí les pasé esos drivers: el precio de la semana, los eventos y feriados, y los días SNAP (los días en que se reparten los beneficios de alimentación en Estados Unidos, que disparan la venta de comida). Con esa información, el mejor modelo bajó el error a 8,7%.
Lo más interesante es cuál de esos drivers pesó más. No fueron los feriados ni los días SNAP. Fue el precio, que resultó ser la segunda variable más importante de todas, por encima de casi toda la historia reciente de ventas.
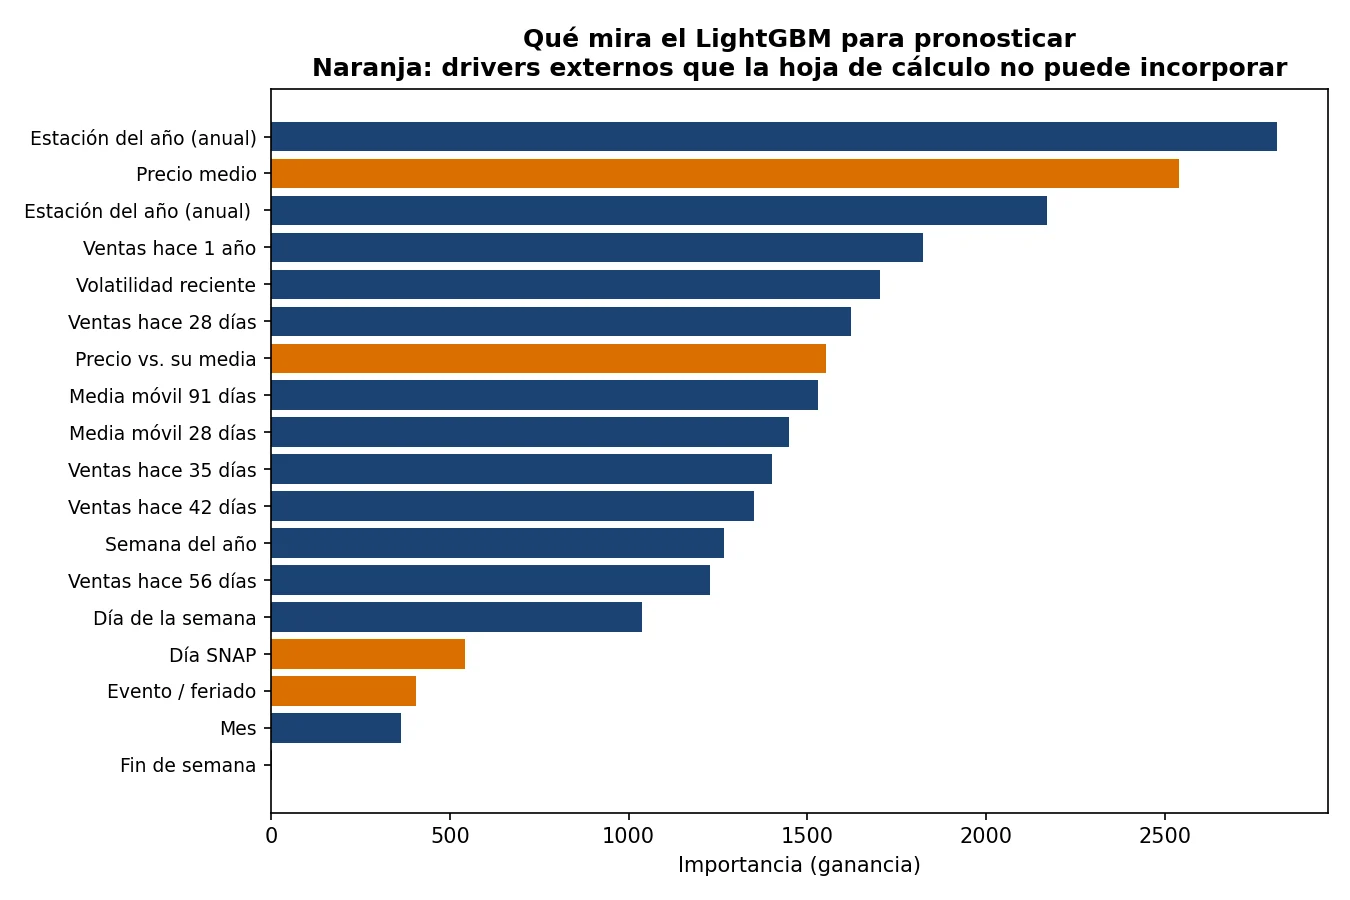
Esto es lo que ninguna fórmula de Excel puede hacer, no por falta de potencia, sino por diseño: incorporar el precio, la promoción y el calendario comercial dentro del pronóstico. Y ese, casi siempre, es el factor que de verdad explica por qué un producto se vendió como se vendió.
6. El 18% traducido a pesos
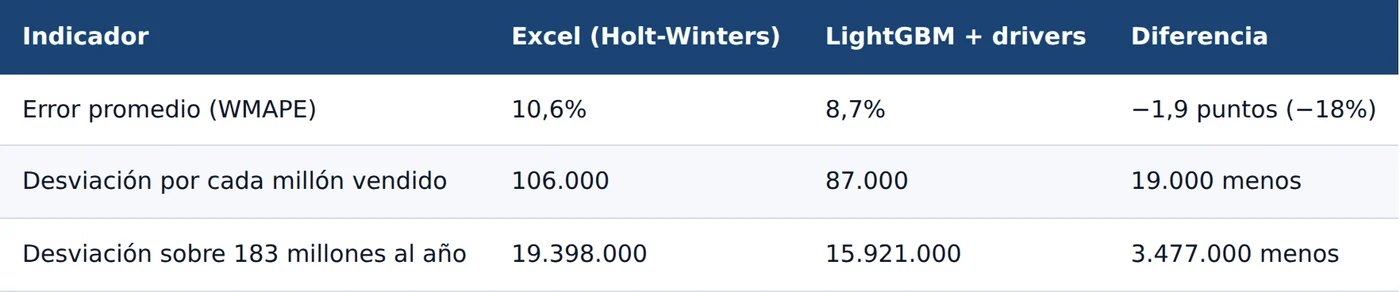
Un 18% de mejora suena abstracto. Bajémoslo a dinero, que es donde de verdad se siente. La ventaja del WMAPE es que se traduce solo: es el error promedio expresado como porcentaje de las ventas, así que basta con multiplicarlo por lo que facturas.
Por cada millón de pesos que vendes, el mejor método de Excel se desvía, en promedio, en unos 106.000 pesos (su 10,6% de error); LightGBM con drivers, en unos 87.000 (su 8,7%). Son 19.000 pesos menos de desviación por cada millón vendido, sobre exactamente los mismos datos.
Esa desviación no es un número de reporte: es dinero que se va por dos lados, según el pronóstico quede por encima o por debajo de la venta real.
- Cuando queda por encima, compras o produces de más. Ese excedente es capital inmovilizado en inventario, espacio de bodega ocupado y riesgo de merma u obsolescencia.
- Cuando queda por debajo, te quedas sin producto. Es venta perdida, margen que no recuperas y, muchas veces, un cliente que se va a la competencia.
El WMAPE no distingue la dirección del error: mide la magnitud, vengas por encima o por debajo. Y una operación real vive las dos caras a la vez, casi siempre al mismo tiempo en distintos productos.
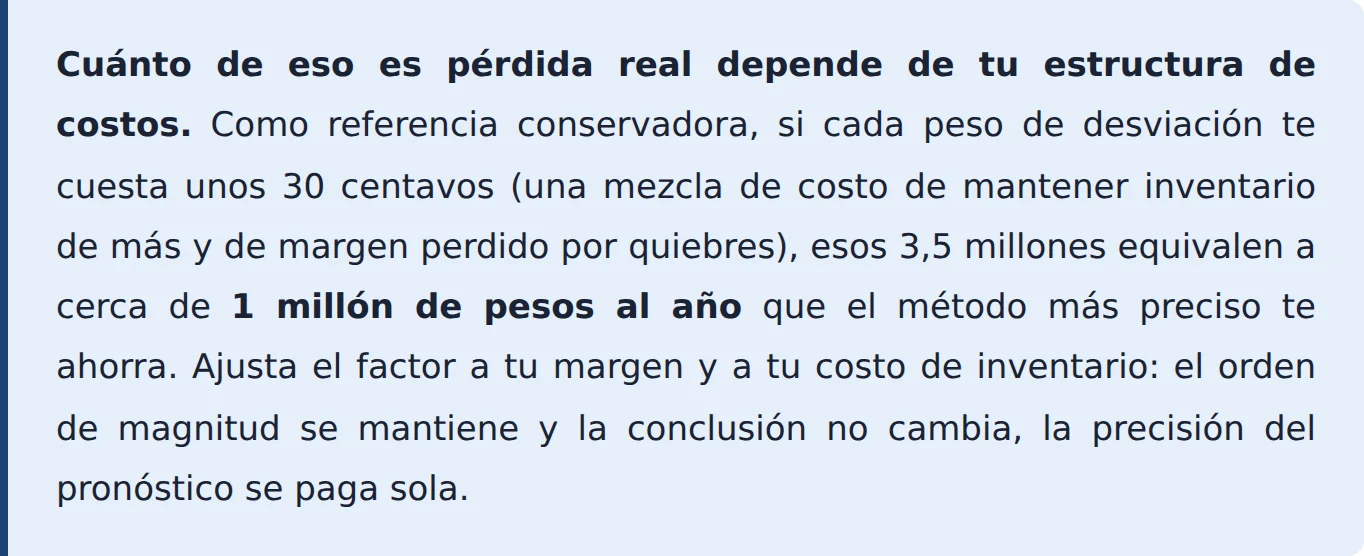
Llevémoslo a una empresa concreta. En la República Dominicana, la ley clasifica como mediana empresa a la que factura entre unos 77 y 288 millones de pesos al año (Resolución 079-2025 del MICM, que actualiza por inflación las leyes 488-08 y 187-17). Tomemos el punto medio de ese tramo, una pyme que factura 183 millones de pesos al año. Con Excel arrastra una desviación promedio de unos 19,4 millones; con LightGBM, de unos 15,9 millones. Son 3.477.000 pesos de desviación menos al año, solo por elegir mejor el método sobre los mismos datos.
7. La frontera que se está borrando
Aquí es donde quiero salirme de los números, porque hay un cambio de fondo que me parece más importante que cualquier punto de WMAPE.
Durante años, la razón por la que la hoja de cálculo ganaba no era que fuera mejor. Era que el otro lado, el de los modelos, exigía saber programar. Esa barrera era el verdadero foso que protegía a Excel. Y ese foso se está secando.
Microsoft metió Python dentro de Excel. Hoy, desde una celda, con la función =PY(), se pueden usar las mismas librerías que usé en este experimento y entrenar un modelo de pronóstico sin abandonar la hoja de cálculo. La dicotomía “Excel o código” simplemente dejó de ser cierta. Conviven en el mismo archivo.
Al mismo tiempo, los asistentes conversacionales bajaron la otra mitad de la barrera. Hoy una persona puede pedir en lenguaje natural que le armen un modelo de pronóstico sobre sus datos y obtener el resultado. La dificultad que protegía a la hoja de cálculo, por los dos flancos, se evapora.
No es que Excel quede atrás. La misma ola que trae los modelos también potencia a la hoja de cálculo con asistentes y fórmulas inteligentes. Lo que cambia es dónde queda la ventaja real: ya no en la herramienta, sino en el criterio de quien la usa.
8. Entonces, ¿qué herramienta debo usar?
Mi respuesta, después de este experimento, no es “usa siempre Machine Learning”. Es “sabe en qué peldaño estás y por qué”. Estas son las preguntas que de verdad deciden:
- ¿Cuántas series pronosticas? Para una o dos, una buena fórmula de hoja de cálculo basta y sobra. Para cientos o miles de productos, montar un solo modelo que las cubra todas deja de ser lujo y pasa a ser la única opción sensata.
- ¿Tu demanda depende de drivers externos? Si el precio, las promociones o el calendario comercial mueven tus ventas, una fórmula nunca va a competir, porque no puede ver esas variables. Ahí el modelo no es opcional.
- ¿Cuánto te cuesta el error? Si cinco puntos de error significan quiebres de stock o capital inmovilizado, invertir en precisión se paga solo. Si no, no te compliques.
El profesional valioso ya no es el que domina más librerías de Python ni el que defiende su herramienta favorita. Es el que, frente a un problema concreto, sabe en qué peldaño pararse y por qué. Esa decisión, y no el software, es lo que separa un pronóstico que sirve de uno que solo llena una celda.
Si este contenido te resultó útil
La distancia entre un pronóstico amateur y uno serio se cruza por peldaños, y hoy varios de esos peldaños ya viven dentro de las mismas herramientas que usas todos los días. El experimento completo de este artículo, con datos reales y código abierto, está disponible para que lo revises, lo corras y lo adaptes a tus propios datos.
⭐ Si te resultó útil, comparte este artículo con alguien que todavía pronostica sus ventas con un promedio.
🔗 ¿Quieres comprobarlo con tus propios números? Córrelo en el navegador, sin instalar nada, y carga tus datos en este notebook (Google Colab): https://colab.research.google.com/github/leanmasterpymes/Fcst_tools/blob/master/experimento/notebooks/excel_vs_ml.ipynb. Código completo: https://github.com/leanmasterpymes/Fcst_tools
💬 ¿En tu operación el pronóstico se hace en hoja de cálculo o ya dio el salto? Me interesa leer tu experiencia.
📩 Si quieres pronósticos confiables en tus ventas, puedes contactarme mediante mensajes directos.
Fuentes y materiales:
- Repositorio del experimento (código abierto, licencia MIT): https://github.com/leanmasterpymes/Fcst_tools
- Notebook para correrlo en el navegador y con tus propios datos (Google Colab): https://colab.research.google.com/github/leanmasterpymes/Fcst_tools/blob/master/experimento/notebooks/excel_vs_ml.ipynb
- M5 Forecasting Competition (Walmart), dataset público de ventas diarias 2011-2016.
- Documentación de PRONOSTICO.ETS (Holt-Winters) y de Python en Excel.
#PronósticoDeVentas #MachineLearning #CienciaDeDatos #Pymes #LeanmasterPymes