Perspectiva técnica
Más allá de Ishikawa, los 5 porqués y FMEA: descifrar la causalidad de problemas industriales complejos con ML e IO
Un método reproducible que combina Machine Learning, inferencia causal e Investigación de Operaciones para llegar a la causa real cuando el análisis de causa raíz clásico ya no alcanza.
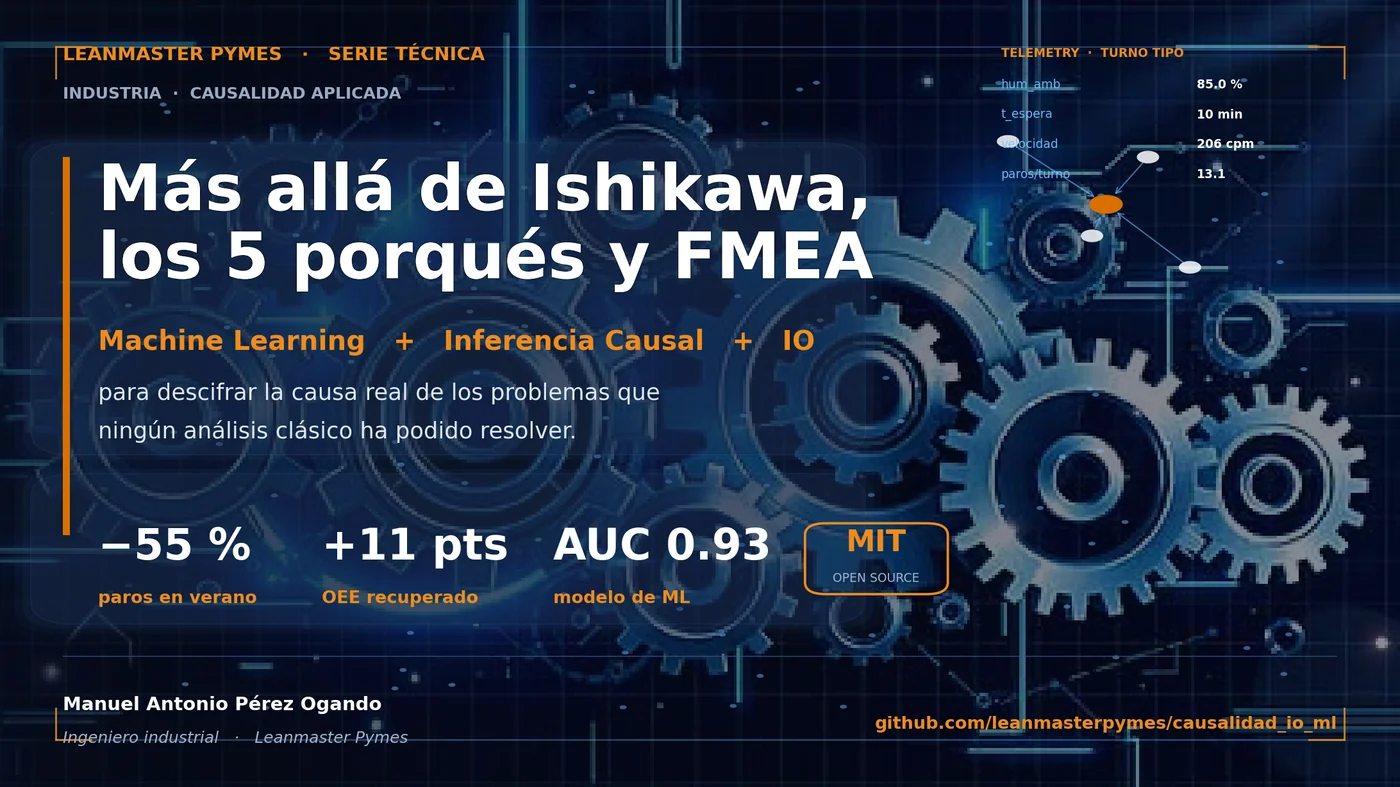
Un método reproducible que combina Machine Learning, Inferencia Causal e Investigación de Operaciones para llegar a la causa real cuando las herramientas clásicas de análisis de causa raíz ya no alcanzan.
Lectura · 7 min Open source · MIT PYMES · Industria Caso reproducible
Demo y código sin instalación
Antes de leer, abre el sistema funcionando en tu navegador:
- ⭐ Repositorio en GitHub (código abierto, MIT): clónalo y ejecuta el flujo completo en tu computadora.
- 📓 Notebook en Google Colab: el caso de estudio paso a paso, sin instalar nada.
- 👉 App interactiva en Streamlit: predictor de paros, DAG navegable y optimizador de setpoints en un solo lugar.
1. La etiqueta que oculta la causa
En toda planta industrial existe una etiqueta que todos repiten y nadie entiende del todo. En unas es “lote malo”. En otras es “mala calidad del proveedor”, “materia prima rara”, “problema del clima”. Todos saben que ahí hay un problema, todos lo escriben en el reporte de paro, y todos asumen que alguien más algún día lo va a resolver. No es ignorancia, es el techo del conocimiento del sistema productivo en ese momento.
Y hay otra cosa que pasa, más incómoda de admitir: muchas empresas, después de varios intentos fallidos, terminan resignándose a convivir con esos problemas crónicos. Aceptan que hay una temporada mala, un mes malo, una semana mala. Planifican alrededor de esa ineficiencia, ajustan los presupuestos para absorberla y la incorporan al manual como si fuera una verdad de la naturaleza. La causa no se identifica, así que el equipo deja de buscarla. La etiqueta sobrevive a varias generaciones de ingenieros.
El caso que ilustra este artículo viene de planta. Trabajé varios años en producción de una fábrica dominicana de caldos de pollo en tabletas (sopitas), y todos los veranos pasaba lo mismo. Las paradas de las compresoras, una docena de máquinas que prensaban y laminaban la masa formulada en tabletas perfectas, se disparaban hasta un 1.000 % respecto a los meses de invierno. Productividad abajo, calidad inestable, disponibilidad por el suelo. Tres meses de planta desmoralizada esperando que el calendario hiciera su trabajo.
En los reportes de paradas todos escribíamos lo mismo: masa húmeda. Operarios, supervisores, jefes de turno, técnicos de mantenimiento. Era el código compartido para decir “no sabemos qué pasa, pero la masa no compacta bien y la máquina se tranca”.
Quien opera manufactura en República Dominicana sabe lo que significa el verano. La humedad relativa se queda pegada por encima del 80 % durante semanas, y cualquier proceso productivo que toque polvos, masas, harinas, sales o materiales higroscópicos (es decir, materiales que absorben humedad del ambiente) empieza a comportarse distinto. Lo que en febrero corría con un OEE digno, en julio se desordena. Masa húmeda no era una causa, era el techo del conocimiento del sistema productivo en ese momento. El equipo de formulación lo intentó por su lado y no encontró ninguna reformulación que aguantara el verano. Ni mantenimiento ni mejora continua llegaron al fondo del asunto. La etiqueta sobrevivió a todos.
Más de diez años después, con la caja de herramientas de Investigación de Operaciones y Machine Learning a mano, vuelvo a aquel problema y lo veo distinto. Lo que sigue es el método que lo descifra, construido para que cualquier responsable de operaciones pueda replicarlo en su propia planta, sea o no una fábrica de caldos.
2. Por qué los métodos clásicos se quedan cortos
Las herramientas clásicas de análisis de causa raíz (Ishikawa, los 5 porqués, FMEA, 8D, Pareto-causal) son indispensables y siguen siendo el primer recurso de cualquier equipo de mejora continua serio. Funcionan extraordinariamente bien cuando el problema tiene una causa dominante, una cadena de razonamiento corta y un conjunto pequeño de variables que entran al análisis. Para alrededor del 60 al 70 % de los problemas operativos, son suficientes. Lo que sigue no las reemplaza.
Donde estos métodos empiezan a quedarse cortos es en el 30 al 40 % restante: problemas crónicos, intermitentes, con varias causas interactuando entre sí, en los que ningún “por qué” individual lleva al fondo, porque el fondo es la interacción no lineal de varias variables al mismo tiempo. Masa húmeda era exactamente eso.
La humedad ambiental por sí sola no explicaba nada, porque los inviernos también tenían días con humedad alta sin que la planta se cayera. El tiempo entre el mezclado y la entrada a la prensa por sí solo tampoco explicaba nada, porque la planta operaba con el mismo flujo todo el año. La velocidad de la prensa tampoco, porque era la misma de siempre. La materia prima tampoco, porque cuando se cambiaba de proveedor el verano seguía siendo un desastre. El problema no era ninguna variable aislada, era la combinación de varias variables en condiciones específicas al mismo tiempo. Y ningún Ishikawa pintado en la pizarra captura ese tipo de interacciones.
El cambio de mentalidad. Los métodos clásicos preguntan “¿cuál es la causa?”, asumiendo que existe una. Los métodos que se proponen aquí preguntan “¿cuál es el mecanismo, qué variables lo activan y bajo qué condiciones?”. No es un reemplazo, es un siguiente paso para los problemas que se resisten a la primera vuelta de causa raíz.
3. El método en tres pasos
El método se apoya en tres bloques que se refuerzan entre sí. Cada uno responde una pregunta distinta.
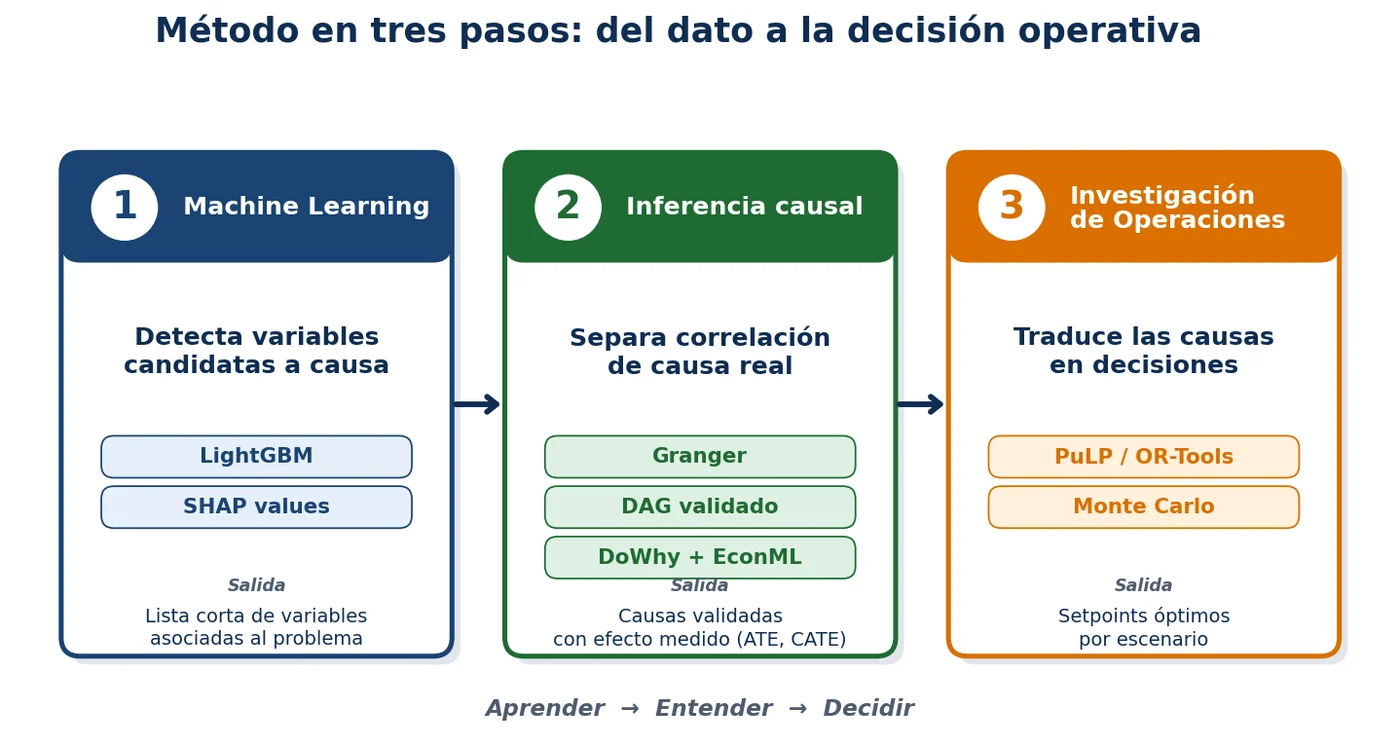
- Paso 1 (Machine Learning): aprende del histórico de planta y propone qué variables están relacionadas con el problema. No decide nada, solo señala con el dedo cuáles son los candidatos.
- Paso 2 (Inferencia causal): toma esa lista corta y separa lo que solo correlaciona de lo que realmente causa. Aquí entran la causalidad de Granger sobre series temporales, el DAG (grafo causal) validado con conocimiento de proceso y la estimación de efectos causales con DoWhy y EconML.
- Paso 3 (Investigación de Operaciones): una vez identificadas las causas controlables, formula y resuelve el problema de decisión que minimiza los paros esperados según las condiciones del turno.
Hay una razón clara para usar los tres pasos juntos y no uno solo:
- Si solo se usa Machine Learning, se encuentran variables que se mueven con el problema, pero no se sabe cuáles son causas y cuáles son consecuencias. El equipo termina tratando de “encontrar la fiebre en la sábana”.
- Si solo se usa inferencia causal, se pueden validar hipótesis ya formuladas, pero no genera la política operativa (por ejemplo, setpoints bien definidos) que aplicar el lunes en planta.
- Si solo se usa Investigación de Operaciones, se optimiza un modelo cuyas causas alguien tuvo que aportar antes. Si esas causas están mal, la solución óptima es óptima sobre un análisis equivocado.
Los tres juntos cierran el ciclo aprender, entender, decidir.
4. Paso 1 · Machine Learning detecta variables candidatas
El insumo es el histórico de planta a nivel de turno, que captura las condiciones de operación de cada bloque de ocho horas. Las variables que entran al modelo se agrupan en cinco familias:
- Ambientales: humedad relativa del aire, temperatura ambiental y punto de rocío. El punto de rocío es la temperatura a la que el aire debe enfriarse para que el vapor de agua empiece a condensarse, sirve como termómetro indirecto de cuán saturado está el ambiente.
- Materia prima: humedad inicial del lote medida por el lab de control de calidad al ingreso a planta (refleja, en una sola cifra, la combinación de materias primas y las condiciones previas de almacenamiento).
- Preparación de la masa antes de la prensa: tiempo de espera entre que la masa sale del área de mezclado y entra a la prensa, y temperatura de la masa al ingresar a la prensa.
- Operación: velocidad de la prensa, medida en ciclos por minuto, lo que en planta se llama golpes.
- Mantenimiento y equipo: días desde el último mantenimiento de cada compresora.
La variable que el modelo trata de predecir es si en el turno hubo o no al menos un paro. Sobre 2.190 turnos de operación (730 días, tres turnos por día), un modelo LightGBM aprende la asociación entre estas variables y la ocurrencia de paros.
Sobre los datos. Las cifras de este artículo no provienen del histórico real de la fábrica de caldos. Esos datos quedaron en la empresa hace más de diez años y no son accesibles. Lo que aquí se usa es un dataset sintético plausible, generado a partir de la memoria operativa del autor, los rangos típicos de procesos similares y la literatura industrial sobre compresión de masas higroscópicas. El mecanismo causal embebido en el dataset reproduce el comportamiento real observado en planta: la relación de paros entre invierno y verano cercana a 1 contra 10, las interacciones entre humedad ambiental, velocidad de la prensa y tiempo de espera, y el efecto diferenciado del turno y de la humedad inicial del lote. El repositorio incluye el código que genera el dataset, así que cualquiera puede revisar exactamente qué hipótesis se asumen y, sobre todo, conectar sus propios datos cuando los tenga.
AUC y SHAP, en lenguaje de planta.
AUC es una métrica que mide qué tan bien el modelo separa los turnos con paro de los turnos sin paro. El modelo obtuvo un AUC de 0.93, que es un resultado muy bueno. Significa que tiene buena capacidad para distinguir un turno riesgoso de un turno normal antes de que ocurra el problema.
SHAP es una técnica que explica por qué el modelo predice lo que predice. No basta con saber “este turno tiene alto riesgo de paro”, lo importante es saber qué variable está generando ese riesgo para poder actuar. SHAP responde: “el riesgo subió principalmente por humedad ambiental alta, mantenimiento atrasado y velocidad de prensa elevada”, no solo “alto riesgo”. Eso es lo que convierte un modelo predictivo en una herramienta de operación.
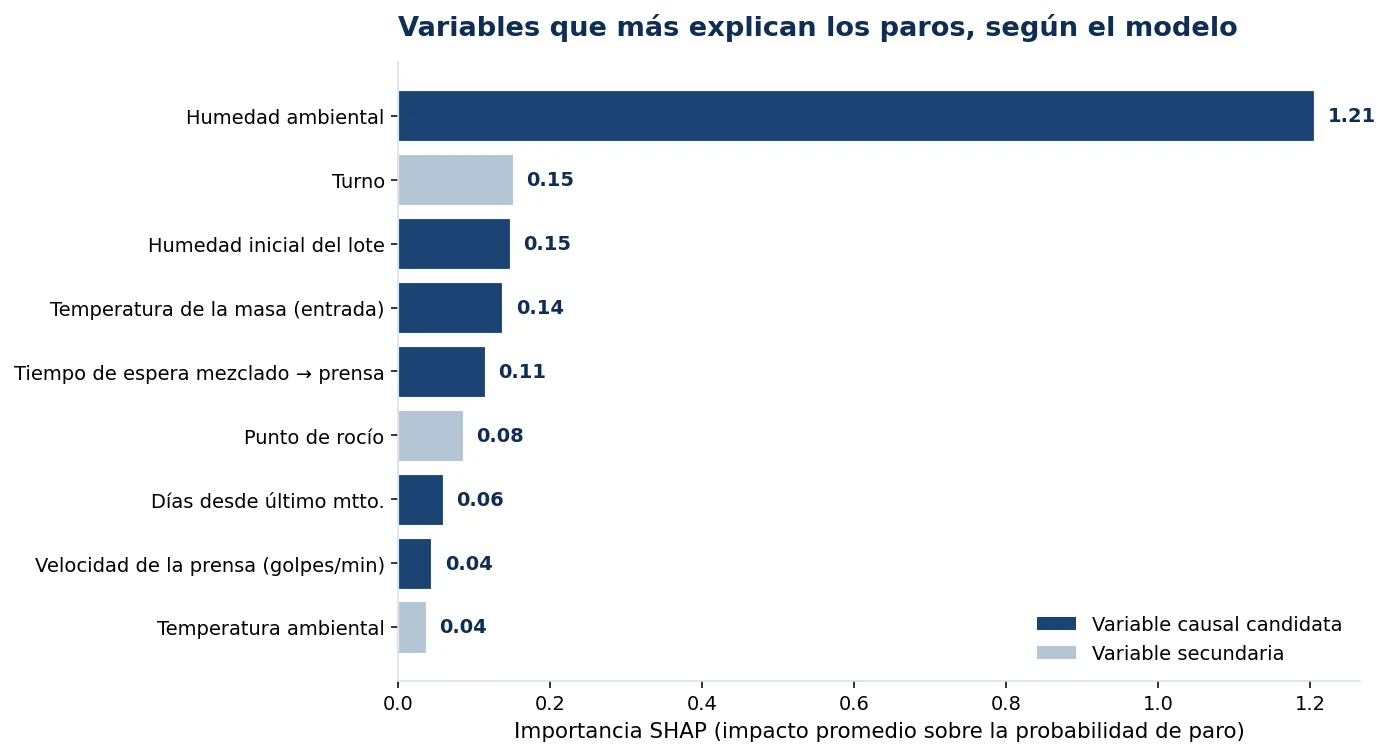
El ranking SHAP entrega un mapa claro. La humedad ambiental domina por más de siete veces sobre el segundo factor (1.21 contra 0.15). Le siguen, con impactos similares entre sí, el turno, la humedad inicial del lote, la temperatura de la masa a la entrada y el tiempo de espera entre mezclado y prensa. La velocidad de la prensa, los días desde el último mantenimiento y la temperatura ambiental quedan en un segundo plano, con menor impacto promedio.
Lo que el Machine Learning no dice todavía: cuáles de esas variables son causa directa, cuáles son causa indirecta a través de otra y cuáles son simplemente síntomas que correlacionan con el problema. Para eso entra el siguiente paso.
5. Paso 2 · Inferencia causal valida
La inferencia causal no es una sola técnica: es una secuencia de tres filtros, cada uno con un rol específico.
Causalidad de Granger sobre series temporales
El primer filtro es temporal. La idea es simple: si conociendo el pasado de una variable se predice mejor el futuro del objetivo que sin conocerlo, esa variable aporta información causal sobre el objetivo. No es la última palabra sobre causalidad, pero descarta correlaciones que solo aparecen por coincidir en el tiempo y se queda con las que sí preceden al evento.
Sobre las series de turnos del caso de estudio, la humedad ambiental y el tiempo de espera pasan Granger con holgura. La velocidad de la prensa pasa marginalmente. La presión de cámara, que algunos esperaban ver, no pasa: no aporta información causal y queda descartada.
DAG validado con conocimiento de proceso
El segundo filtro es estructural. Las variables candidatas se organizan en un grafo dirigido (un DAG, por Directed Acyclic Graph), donde cada flecha representa “esto causa esto”. El grafo no se construye solo desde los datos. Los algoritmos automáticos de descubrimiento causal no son muy confiables en datasets de planta pequeños, así que el DAG se construye con el equipo de proceso, mantenimiento y calidad, usando los datos como evidencia para resolver discusiones.
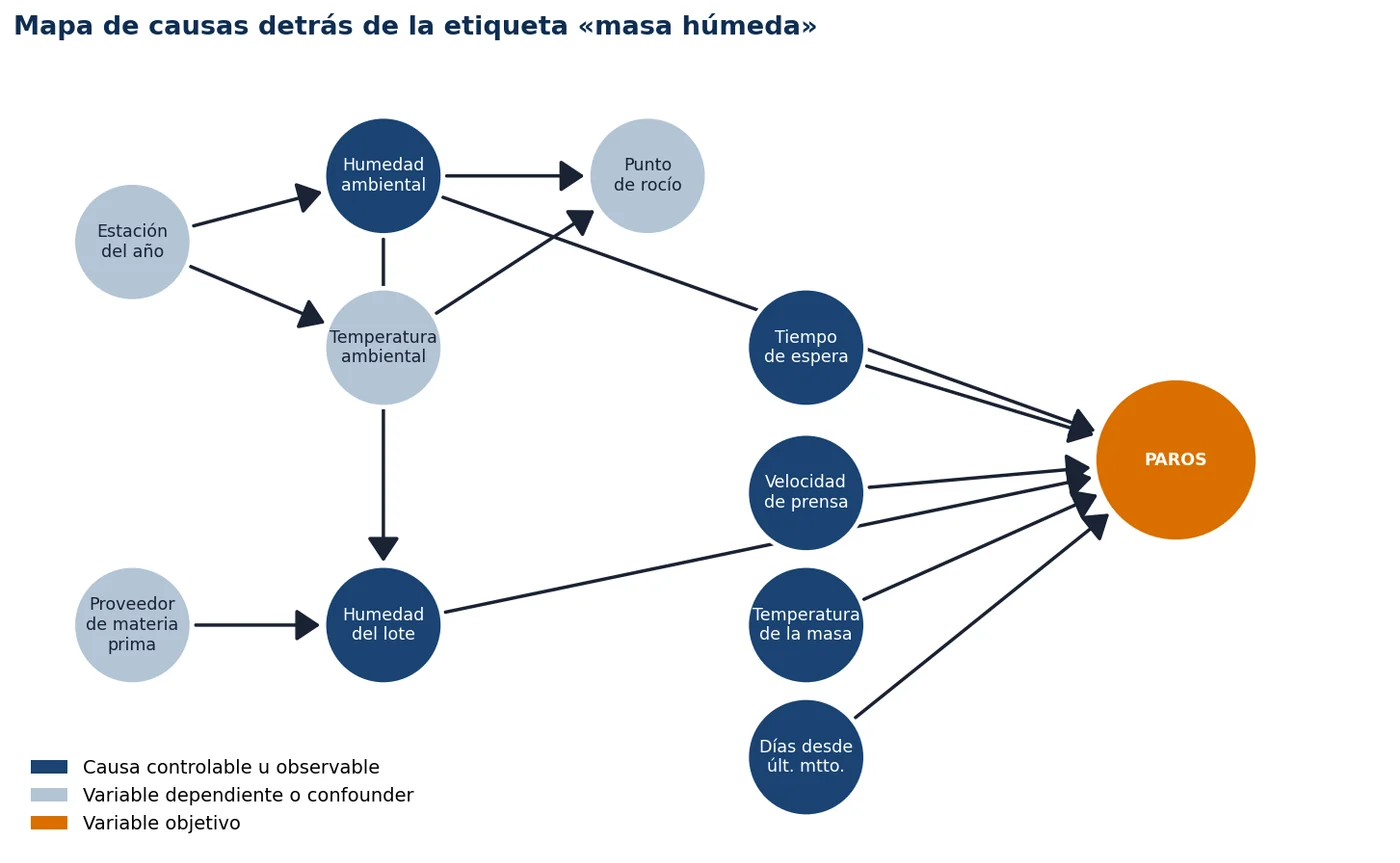
El DAG revela algo que el ranking SHAP por sí solo no muestra:
- El punto de rocío es una variable dependiente, es decir, se calcula a partir de la humedad y la temperatura, no es causa independiente. Aparece en el ranking SHAP por correlación, no por causa.
- La temperatura ambiental no actúa directamente sobre los paros, actúa a través de la humedad ambiental.
- La estación del año es un confounder, es decir, una variable que afecta a la vez al supuesto causante (la humedad y la temperatura) y al resultado (los paros), generando una correlación que parece causa pero no lo es. Por eso aparece como predictor sin ser causa directa.
- La humedad inicial del lote depende de la combinación de materias primas usada en cada formulación y de las condiciones de almacenamiento previas, pero además sube cuando el lote espera en piso con humedad ambiental alta. Eso explica por qué algunos lotes “se portan mal” solo en verano.
Estimación de efectos causales: ATE y CATE
El tercer filtro es cuantitativo. Una vez el DAG está validado, se pueden responder dos preguntas concretas, en números:
- ATE (Average Treatment Effect, efecto causal promedio): si la humedad ambiental sube por encima del 78 %, ¿cuántos paros adicionales se esperan por turno, en promedio? Respuesta del modelo causal: +13 paros adicionales por turno en la línea de doce máquinas, ajustado por turno, categoría del lote, velocidad de la prensa y tiempo de espera.
- CATE (Conditional Average Treatment Effect, efecto causal condicional): ese efecto, ¿es igual para todos? No. El turno 3 (de diez de la noche a seis de la mañana, el de la amanecida) es por mucho el más resistente a la humedad alta: cuando llega un lote seco (humedad inicial menor al 12 %, medida en el lab de calidad), el efecto cae a +6.5 paros; con lote húmedo (humedad inicial mayor o igual al 12 %), sube a +9.1. En cambio, el turno 2 (de dos de la tarde a diez de la noche, que arrastra las horas más calientes del día) es el peor: con un lote húmedo llega a +23.5 paros adicionales por turno. Eso justifica políticas diferenciadas por turno y por condición del lote, no un setpoint único.
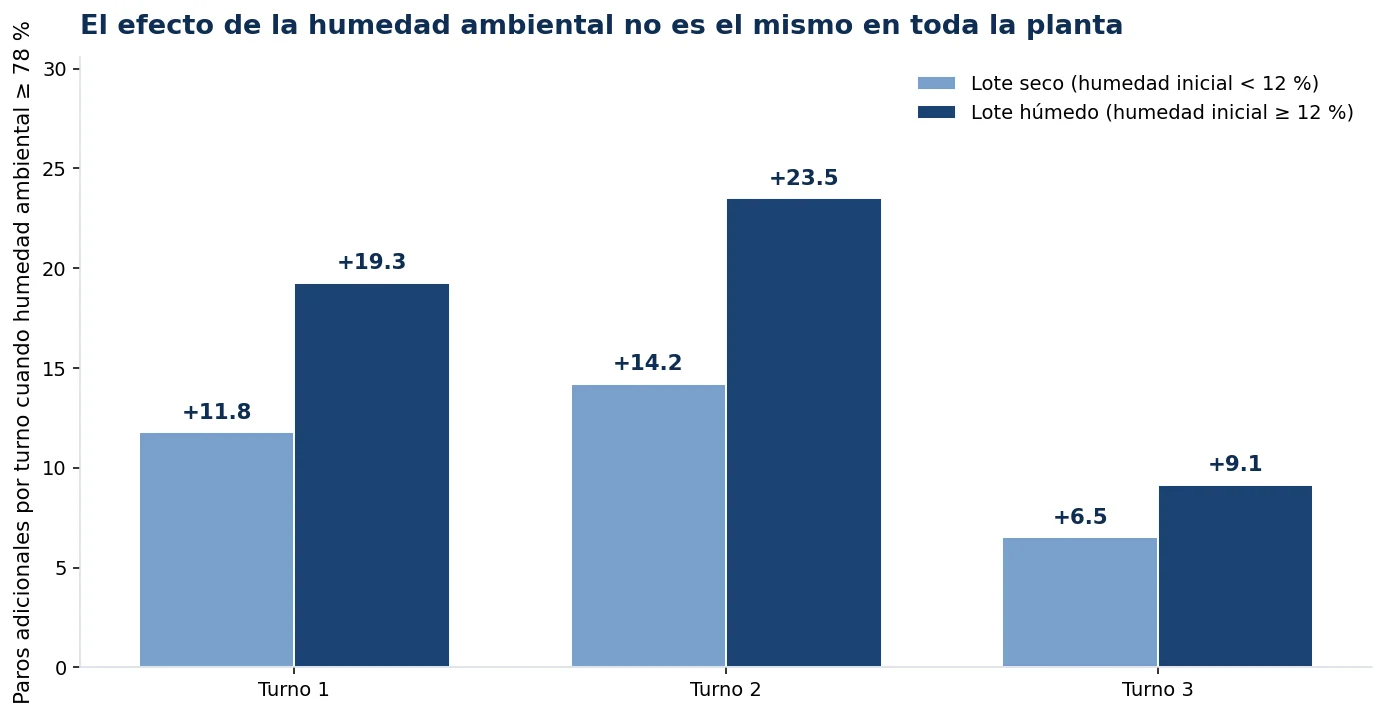
Lo que el modelo confirma es lo que se sabía en piso. En la planta, todos los que llevaban tiempo en el área de manufactura sabían tres cosas que ningún reporte recogía: que el turno 3 (la amanecida) corría mejor que los turnos de día porque la temperatura baja en la noche y con ella la humedad del aire que rodea la masa; que cuando se bajaban los golpes (velocidad de la prensa) las máquinas paraban menos; y que cuando se daba más tiempo de enfriamiento al lote antes de bajarlo del cuarto frío, la masa llegaba a las compresoras en mejores condiciones. La inferencia causal no descubre la verdad, le pone número y prioridad a la intuición de quien lleva años en el área de manufactura.
Con esto, masa húmeda deja de ser una etiqueta y se convierte en una tabla de combinaciones críticas: humedad ambiental alta, más lote con humedad inicial alta, más tiempo de espera elevado en turno 2, más velocidad de prensa alta, suman paro casi seguro. Y al revés: la misma humedad ambiental, con un lote seco, tiempo de espera corto, velocidad ajustada y operando en turno 3, queda manejable.
6. Paso 3 · Investigación de Operaciones decide
Saber la causa no resuelve nada si no se traduce en setpoints concretos para el próximo turno. La humedad ambiental no se puede controlar: el verano viene con lo que viene. Pero el tiempo de espera y la velocidad de la prensa sí se pueden ajustar.
La pregunta de Investigación de Operaciones es directa: dadas las condiciones que entran al turno (humedad ambiental, humedad inicial del lote, días desde mantenimiento), ¿cuál es la combinación de tiempo de espera y velocidad de prensa que minimiza paros esperados sin sacrificar la producción nominal?
El problema se formula con dos objetivos: minimizar la intensidad de paros (heredada del modelo causal) y penalizar la pérdida de productividad cuando la velocidad cae por debajo del nominal. Las restricciones definen el rango operativo realista. La velocidad de la prensa tiene un piso de 180 cpm (golpes) y un techo de 244 cpm (golpes). El tiempo de espera tiene un mínimo técnico de mezclado y un máximo razonable de cola entre el mezclador y la prensa.
Para un turno tipo de verano (humedad ambiental 85 %, lote con humedad inicial 12.8 %, 20 días desde mantenimiento), el optimizador recomienda: tiempo de espera 10 min, velocidad 206 cpm (golpes, cerca del piso del rango), paros esperados alrededor de 13 por turno para la línea de doce máquinas, OEE 74 %. Contra una operación histórica que ese mismo turno dejaba con 29 paros y un OEE del 56 %. Hay un piso de paros irreducible que la nueva política no puede eliminar (la humedad ambiental atraviesa la masa por difusión), pero el optimizador captura la mejor combinación posible dadas las condiciones.
Sobre el conjunto de turnos del histórico, una simulación Monte Carlo con 50 réplicas estima el impacto de aplicar la política nueva durante un año completo.
Una palanca estructural que el método no decide: la climatización del cuarto frío
El optimizador trabaja con setpoints que se pueden cambiar de un turno al siguiente. Tiempo de espera y velocidad son palancas de operación: no requieren inversión. Pero el modelo causal deja a la vista una palanca que no es de operación, es de planta. La masa llega a las compresoras desde un cuarto frío donde se mezcla y se aclimata. Si ese cuarto tiene aire acondicionado dimensionado solo para invierno, ventilación industrial insuficiente o le faltan deshumidificadores activos en temporada de calor, la masa absorbe humedad del ambiente antes de bajar a la prensa, y todo el esfuerzo de operación pierde fuerza.
Reforzar la climatización del cuarto frío (aire acondicionado adicional dimensionado para los meses de verano, ventiladores industriales para mover el aire seco, un banco de deshumidificadores activos en temporada) es una inversión complementaria al método, no un reemplazo. Cuando la masa baja a las compresoras con humedad mejor controlada, el optimizador puede tomar decisiones más holgadas (velocidades más altas, ciclos más rápidos) sin perder estabilidad. El método dice exactamente dónde la inversión vale la pena y cuánto se recupera.
7. El caso “masa húmeda”, resuelto
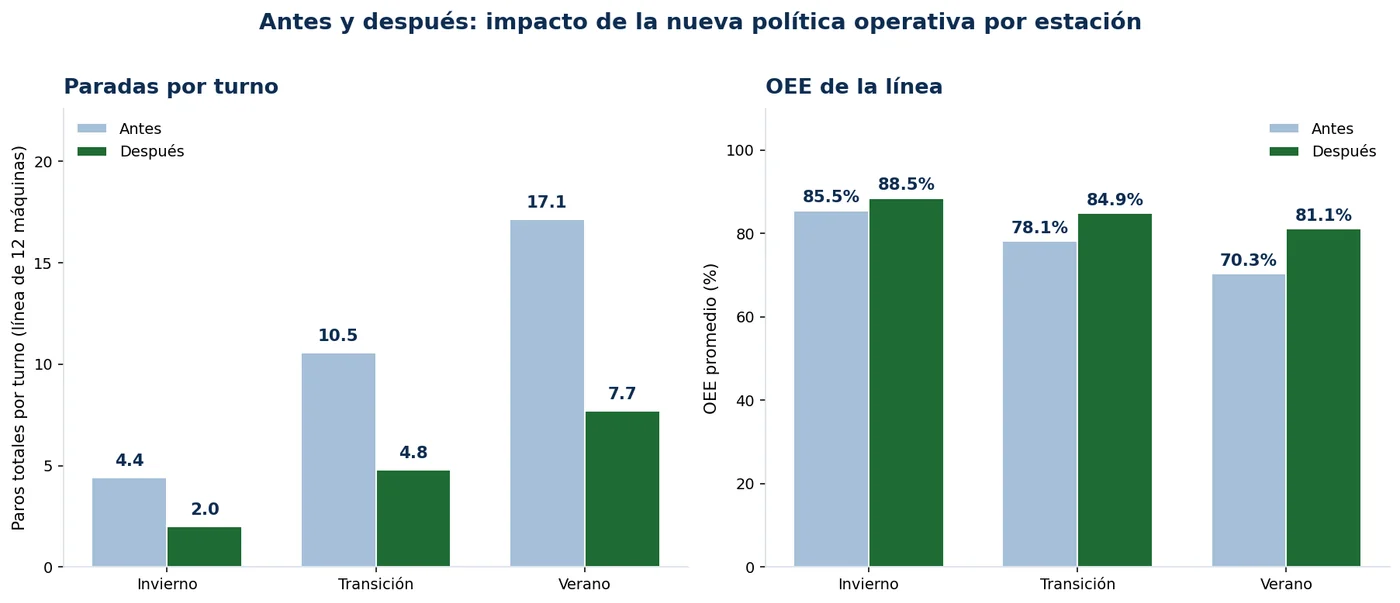
Los resultados aplicados al caso de estudio se traducen en cinco beneficios operativos medibles, que recuperan el OEE de verano hasta dejarlo prácticamente igual al de invierno y reducen drásticamente la presión sobre el mantenimiento correctivo de las compresoras.
−55 % en verano Paradas por turno (línea de 12 máquinas)
La misma planta, las mismas doce máquinas, las mismas condiciones climáticas. Lo único que cambia es el setpoint que entra a cada turno según sus condiciones. Diecisiete paros por turno se reducen a ocho. No es el regreso al funcionamiento normal, porque hay un piso de paros que la humedad ambiental impone y ningún setpoint puede eliminar. Es, eso sí, recuperar la mitad de la capacidad operativa perdida cada verano.
+11 puntos OEE en verano Recuperación del indicador estrella
De un OEE de 70 % en la operación histórica del verano a un OEE de 81 % con la nueva política. Once puntos de OEE no es una mejora cosmética: representan la diferencia entre una planta que pelea por sostener el plan y una planta que opera con margen razonable. Equivale a recuperar más de un tercio de la capacidad productiva perdida cada verano, suficiente para liberar espacio para órdenes que antes se rechazaban por falta de disponibilidad y para reducir significativamente los turnos extras del fin de semana.
−40 a −55 % Mantenimiento correctivo de compresoras
Cada parada por masa húmeda fuerza las compresoras contra una masa que no compacta. Rodamientos, levas, troqueles, sellos y guías móviles se reemplazan con una frecuencia que no aparece en el plan preventivo. Reducir los paros reduce el desgaste no programado de toda la línea.
−30 a −45 % Sustitución de piezas movibles
Las roturas por sobrecarga obligan a sustituir partes originales por repuestos genéricos que arrastran pérdida de rendimiento durante meses. Estabilizar la operación protege la vida útil del activo y evita el desgaste irreversible que se acumula verano tras verano.
−50 a −65 % Costo total de no calidad en verano
Suma scrap, retrabajos, mantenimiento correctivo, energía perdida y costo de oportunidad de la línea detenida. El verano dejaba un agujero anual que ahora cabe en el plan operativo sin reformulaciones de producto ni inversiones en equipo.
El costo invisible que muy pocos cuantifican. Tres veranos de operación forzada equivalen, en costo real, a un cuarto verano que la planta nunca facturó. La política nueva no solo recupera el OEE, sino que también protege el CapEx que ya se ejecutó cuando se compraron las máquinas.
8. Cuándo aplicar este método y cómo probarlo
El método encaja cuando se cumplen al menos dos de estas tres condiciones:
- El problema es crónico o estacional, no un evento aislado.
- Hay una etiqueta compartida en los reportes de paro o de no calidad que todos repiten y nadie puede sostener con un mecanismo causal claro.
- Existen datos de operación con suficiente granularidad y suficiente historia (idealmente más de un año, capturando estacionalidad).
La etiqueta del caso fue masa húmeda, pero el patrón aparece bajo otros nombres en cualquier industria sensible a condiciones ambientales o a la variabilidad de la materia prima: café soluble, sazonadores, lácteos en polvo, fertilizantes, cementos, tabaco y productos farmacéuticos comprimidos. Si se reconoce el patrón en su planta, el método es replicable.
Opción rápida, sin instalar nada
Abre el botón “Open in Colab” del repositorio. Las celdas ejecutan en orden el flujo completo: caso de estudio, modelo ML, ranking SHAP, Granger, DAG validado, ATE, CATE y simulación Monte Carlo de la política nueva. En menos de tres minutos, todo está corriendo en una pestaña del navegador.
Opción para implementarlo, clonar el repositorio
🔗 **El código completo está publicado bajo licencia MIT en **github.com/leanmasterpymes/causalidad_io_ml. Cualquiera puede clonarlo, correr el sistema en su computadora y conectar los datos históricos de su propia planta. La app Streamlit abre en el navegador y permite explorar el predictor de paros, navegar el DAG y consultar el optimizador de setpoints sin tocar una línea de código.
Sobre el OEE como métrica
El OEE (Overall Equipment Effectiveness) se usa en este artículo como métrica ancla por ser la más reconocida en producción. Para una discusión más extensa de cómo se mide en tiempo real y se gestiona desde el piso de planta, recomiendo el artículo previo de esta serie sobre OEE en tiempo real con MQTT, Andon digital y Machine Learning para PYMES, publicado en github.com/leanmasterpymes/oee-andon-ml.
🔬 ¿Quieres profundizar en el detalle técnico?
Para profesionales técnicos, estudiantes de Investigación de Operaciones y científicos de datos que quieran entender el método por dentro, el repositorio incluye una versión extendida del artículo y un notebook ejecutable paso a paso con:
- La formulación del test de causalidad de Granger sobre la serie de paros por turno, con los p-valores reales del caso.
- La construcción del DAG validado y el código de identificación de efecto causal en DoWhy y EconML.
- El estimador del ATE por estratificación sobre confounders observables y la heterogeneidad por CATE.
- La formulación del problema de optimización de setpoints con PuLP y la simulación Monte Carlo del impacto operativo anual.
- Referencias: Pearl (Causality, 2009), Imbens y Rubin (Causal Inference, 2015), Granger (1969), Lundberg y Lee (SHAP, 2017).
👉 Abrir el repositorio en GitHub para acceder al material extendido.
Si este contenido le resultó útil
👀 Abra el notebook en Colab antes de cerrar la pestaña, corre con un solo clic, sin instalación.
⭐ Marque el repositorio en GitHub para darle visibilidad y poder clonarlo en su empresa.
💬 Comparta el artículo con su responsable de operaciones, mantenimiento o calidad. El método puede evaluarse en una sola jornada con datos de su propia planta.
📩 Si desea adaptar la solución a un problema crónico específico de su operación o integrar el flujo a sus sistemas, puede contactarme mediante mensajes directos.
Este artículo se publicó primero en LinkedIn.